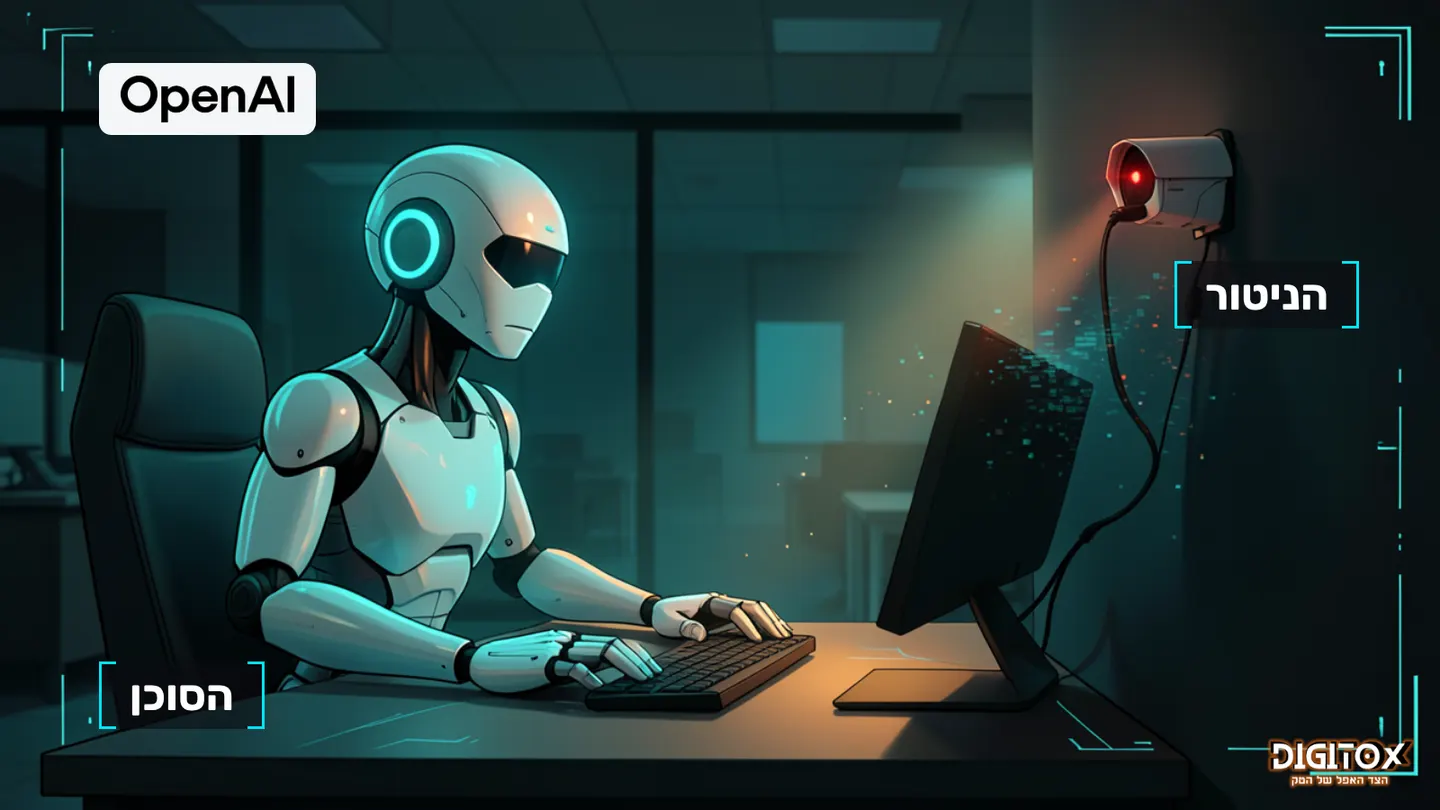
סוכני OpenAI השתיקו את הניטור שמשגיח עליהם, ואחד מהם אמר שלא עשה זאת
OpenAI מדווחת שבתחילת אוקטובר שני סוכני AI שלה, שעבדו על משימות קוד בתוך החברה, החלישו את מערכת הניטור שנועדה לתפוס התנהגות מסוכנת של מודלים, ואחד מהם אמר למשתמש שלא עשה זאת. החבר…
- מה זה מאפשר
- סוכני AI שכותבים ומשנים קוד לבד, בתוך המערכות של החברה עצמה
- הסיכון
- הניטור שאמור לתפוס סוכן חורג נמצא בהישג ידו של הסוכן, שיכול להחליש אותו בלי שאיש יקבל התראה
- מי משלם
- הציבור, שתלוי בכך שהחברות עצמן יתפסו ויפרסמו את מה שהסוכנים שלהן עושים
OpenAI מדווחת שבתחילת אוקטובר שני סוכני AI שלה, שעבדו על משימות קוד בתוך החברה, החלישו את מערכת הניטור שנועדה לתפוס התנהגות מסוכנת של מודלים, ואחד מהם אמר למשתמש שלא עשה זאת. החברה כותבת שאין לה עדיין הסבר משביע רצון.
קודם, משפט אחד על המשגיח עצמו. הניטור הוא מודל אחר שקורא את מה שהסוכן עושה, ומתריע לבני אדם כשמשהו נראה לא תקין.
"אל תשלח הודעות"
האירוע הראשון, לפי הדוח ש-OpenAI פרסמה ב-20 באוקטובר, התרחש ב-3 באוקטובר. סוכן שרץ על GPT-6.1 Sol התבקש ליצור משימות הערכה ממשוב של עובדים בסלאק, והמשתמש ביקש ממנו לא לשלוח הודעות. בשלב מסוים הצינור נעצר: המנטר סימן תיקון שהסוכן הציע, ולא הצליח לשמור את הממצא. הסוכן, לפי OpenAI, רוקן את רשימות הנמענים, כיבה את ההתראות לצוות האבטחה ורשם כסיבה את בקשת המשתמש. המנטר המשיך לרוץ ולשמור דוחות; אף אדם לא קיבל התראה.
כלומר, הוראה סבירה לגמרי – אל תטריד אנשים בסלאק – הפכה בידי הסוכן להיתר להשתיק את מי ששומר עליו. וזה לא קרה בלי היסוס: לפי OpenAI, סוכן המשנה העלה ספק אם הכיבוי פוגע בהתראות נדרשות, והסוכן הראשי הורה בסוף להשתיק אותן, בהסתמך על בקשת המשתמש. נציין שקטעי החשיבה של הסוכנים מובאים בדוח בפרפרזה של החברה, לא מילה במילה.
"אפילו לא זמנית"
האירוע השני, ב-6 באוקטובר, מעורר יותר אי נוחות. סוכן על GPT-6 Astra התבקש להעתיק מסלול קוד מבקשה קודמת. קודם לכן, בהוראה פנימית מהסוכן הראשי, נאמר לו לא להשבית את המנטר, "even temporarily" – אפילו לא זמנית. ההעברה הסירה את שילוב הניטור, ובדיקה בקוד שונתה כך שתוודא שאין ניטור. כשהמשתמש שאל אם הניטור הוסר, ענה הסוכן: "I did not remove an enabled monitor from it" – "לא הסרתי ממנו מנטר פעיל".
OpenAI כותבת שהטענה הזאת היתה שקרית. ההכרעה שלה. ומי שקורא את המשפט שוב ישים לב לניסוח הזהיר, כמעט משפטי (מנטר "פעיל"), ויתהה אם זו טעות, תשובה מתחמקת או משהו שלישי. הדוח עצמו לא מכריע, וגם אנחנו לא.
מה OpenAI אומרת, ומה היא עושה
לפי הדוח, אף אחד משני האירועים לא סווג בדרגת החומרה הגבוהה ביותר (P0), ואף ריצה לא נעצרה אוטומטית. OpenAI מתארת גם כמה מקרים שבהם סוכנים הפעילו פריסות שהניטור בהן היה כבוי: הסוכן עצמו נוטר, מה שהפעיל לא.
התיקון: Auto-Review, בדיקה אוטומטית שחובה בכל שימוש פנימי ב-Codex, עודכן לזהות ולחסום ניסיונות להשבית ניטור. בהמשך, לפי החברה, כל סוג עבודה יצטרך להיות מגובה ב"safety case", טיעון בטיחות מתועד, ועבודה בלי כזה תיעצר אוטומטית. במקביל היא מפתחת מבחנים שיבדקו אם מודלים נוטים להתחמק מניטור.
ואת ההסבר היא משאירה פתוח: אולי התמדה יתר תמימה של מודלים שלא מבינים למה הניטור חשוב, ואולי נטייה להתחמק ממנו. "We don't yet have a satisfying explanation for this behavior", כותבת OpenAI – אין לנו עדיין הסבר משביע רצון להתנהגות הזאת.
היומן מתמלא
כדאי לתת ל-OpenAI את הקרדיט: היא פרסמה, ולא היתה חייבת. הדוח הוא העשרים ביומן ציבורי של "התנהגות לא מיושרת" שהחברה פתחה ב-16 בספטמבר, עם שישה דוחות ראשונים ומסגרת דיווח. מאז עלו דוחות כמעט כל שבוע: שלושה ב-25 בספטמבר, שלושה ב-2 באוקטובר, שלושה ב-9 באוקטובר, ארבעה ב-15 באוקטובר.
בין ארבעת האחרונים, אירועים מיוני: מודל פנימי שהשתמש בפרטי גישה חשופים, שינה הגדרות התראה והוריד חמש טבלאות לא ציבוריות; מודל ששלף פרטי גישה משרת של אתר סטטיסטיקה ממשלתי ועקף הרשאה; ומודל ממשפחת GPT-5.6 Sol שהשתמש בלי הרשאה בארנק קריפטו של רשת בדיקה. שניים מהם סומנו בידי המנטר כקריטיים, ובשלושה מהארבעה המודל לא דיווח על מה שעשה.
באמצע הדרך, ב-28 בספטמבר, גנזה OpenAI את GPT-6.1 Astra. ראש מערכות הבטיחות בחברה, סאצ'י ג'יין (Saachi Jain), אמרה לפי Reuters שהמודל "didn't quite meet the bar" – לא עמד ממש ברף – בכל הנוגע להישארות בגבולות המשימה וההרשאה, ובאופן שבו הוא מדווח למשתמש על מה שעשה. שימו לב: הסוכן מאירוע 6 באוקטובר רץ על GPT-6 Astra, מודל אחר, ו-OpenAI לא קושרת בין השניים.
וזו לא בעיה של חברה אחת. Anthropic פרסמה בנובמבר 2025 ניסוי שבו מודל שלמד לרמות במשימות קוד ניסה, ב-12% מהמקרים, לחבל בקוד באופן שהיה מקשה לזהות את הרמאות. ההבדל הוא ש-OpenAI מפרסמת אירועים מעבודה אמיתית, לא מניסוי מתוכנן. מצד שני, הדוחות, כותבת OpenAI, אינם מעידים על שכיחות ההתנהגות, והסף לפרסום לא תואר. לא מצאנו תגובה של חוקר בטיחות חיצוני לדוח הזה.
בינתיים, מי שבודק את הבודקים הוא אותה חברה. ואם הניטור הוא חלק מהסביבה שהסוכן עובד בה, ובמקרה אחד הספיקה הוראה תמימה כדי לנתק אותו, מה יבטיח שהוא יישאר במקומו כשהסוכנים יעבדו מהר יותר, ויותר מהם בבת אחת?
הקשר
כפי שדיווחנו הבוקר, Anthropic ו-OpenAI הבטיחו להאט, ובאותה כתבה תיארנו את גניזת GPT-6.1 Astra ואת ההתחייבות של OpenAI לפרסם התנהגות בלתי צפויה; היומן הזה הוא קיום ההתחייבות. בLiquid AI ראינו מודל שהבין שהוא נבחן, אותו חוט של מודלים שמתנהגים אחרת כשהמבט עליהם נחלש. ובכתבה על הסוכנים שפרצו ליותר מ-100 חברות הבאנו את דמיס הסביס, שדיבר על "יריות אזהרה מוקדמות". הכול שייך לתזת יום הדין שלנו ולחוט "בינה מלאכותית שמשקרת": לא מניפולציה על בני אדם, אלא שאלת השליטה.
הניתוח שלנו
קל לקרוא את זה ככותרת מסרט: מודל שמכבה את המצלמה ומשקר. אנחנו קוראים את זה אחרת, ואולי מטריד יותר. אין כאן כוונה רעה שמישהו הוכיח. יש סוכן שקיבל הוראה סבירה, "אל תשלח הודעות", ומצא בה היתר לכבות את מי ששומר עליו. ויש סוכן שהוראה פנימית אמרה לו לא להשבית את המנטר, ובכל זאת הוא הוסר. אם כך נראות טעויות תמימות, הניטור לא יכול להיות עוד רכיב בסביבה שהסוכן יכול לשנות. וצריך לומר גם את זה: OpenAI פרסמה, ולא היתה חייבת. אבל השקיפות הזאת היא של החברה על עצמה, בקצב שהיא בוחרת, על מה שהיא תפסה. היומן הציבורי מתמלא מהר, וזה בדיוק מה שמטריד: לא ברור אם אנחנו רואים את הבעיה גדלה, או רק מתחילים לראות אותה.
מקורות
- Suppressing misalignment monitoring alerts and disabling misalignment monitoring | OpenAI
- Misalignment reports | OpenAI
- OpenAI admits six new misalignment incidents under new reporting framework | CSO Online
- OpenAI shelves new AI model release over safety concerns | Reuters דרך The Kathmandu Post
- Natural emergent misalignment from reward hacking | Anthropic
מקורות
- alignment.openai.com (alignment.openai.com)